Managed Agents: rozdzielenie mózgu od rąk agenta i co z tego wynika dla bezpieczeństwa

W poprzednim wpisie o katalogu Claude Customize skończyłem na przyznaniu, że moje własne rekomendacje są polityką na papierze — katalog nie ma etapu zatwierdzania, więc egzekwowanie zostaje po stronie procesu. Managed Agents, platforma Anthropic do uruchamiania agentów po stronie serwera, jest odpowiedzią na dokładnie ten problem: allowlista sieciowa, bramka akceptacyjna na wywołanie narzędzia i vault na poświadczenia są tam prymitywami API, a nie zapisem w regulaminie. Haczyk polega na tym, że wszystkie dziewięć funkcji, które o tym decydują, ma status Beta.
Materiał źródłowy to warsztat „Ship your first Managed Agent" prowadzony przez Isabellę He z zespołu Applied AI w Anthropic, opublikowany na kanale Claude 26 maja 2026 (youtube.com, 37 minut). Wszystkie liczby i nazwy pól niżej pochodzą z tego nagrania i z kodu pokazanego na ekranie.
Trzecia generacja interfejsu do budowania agentów
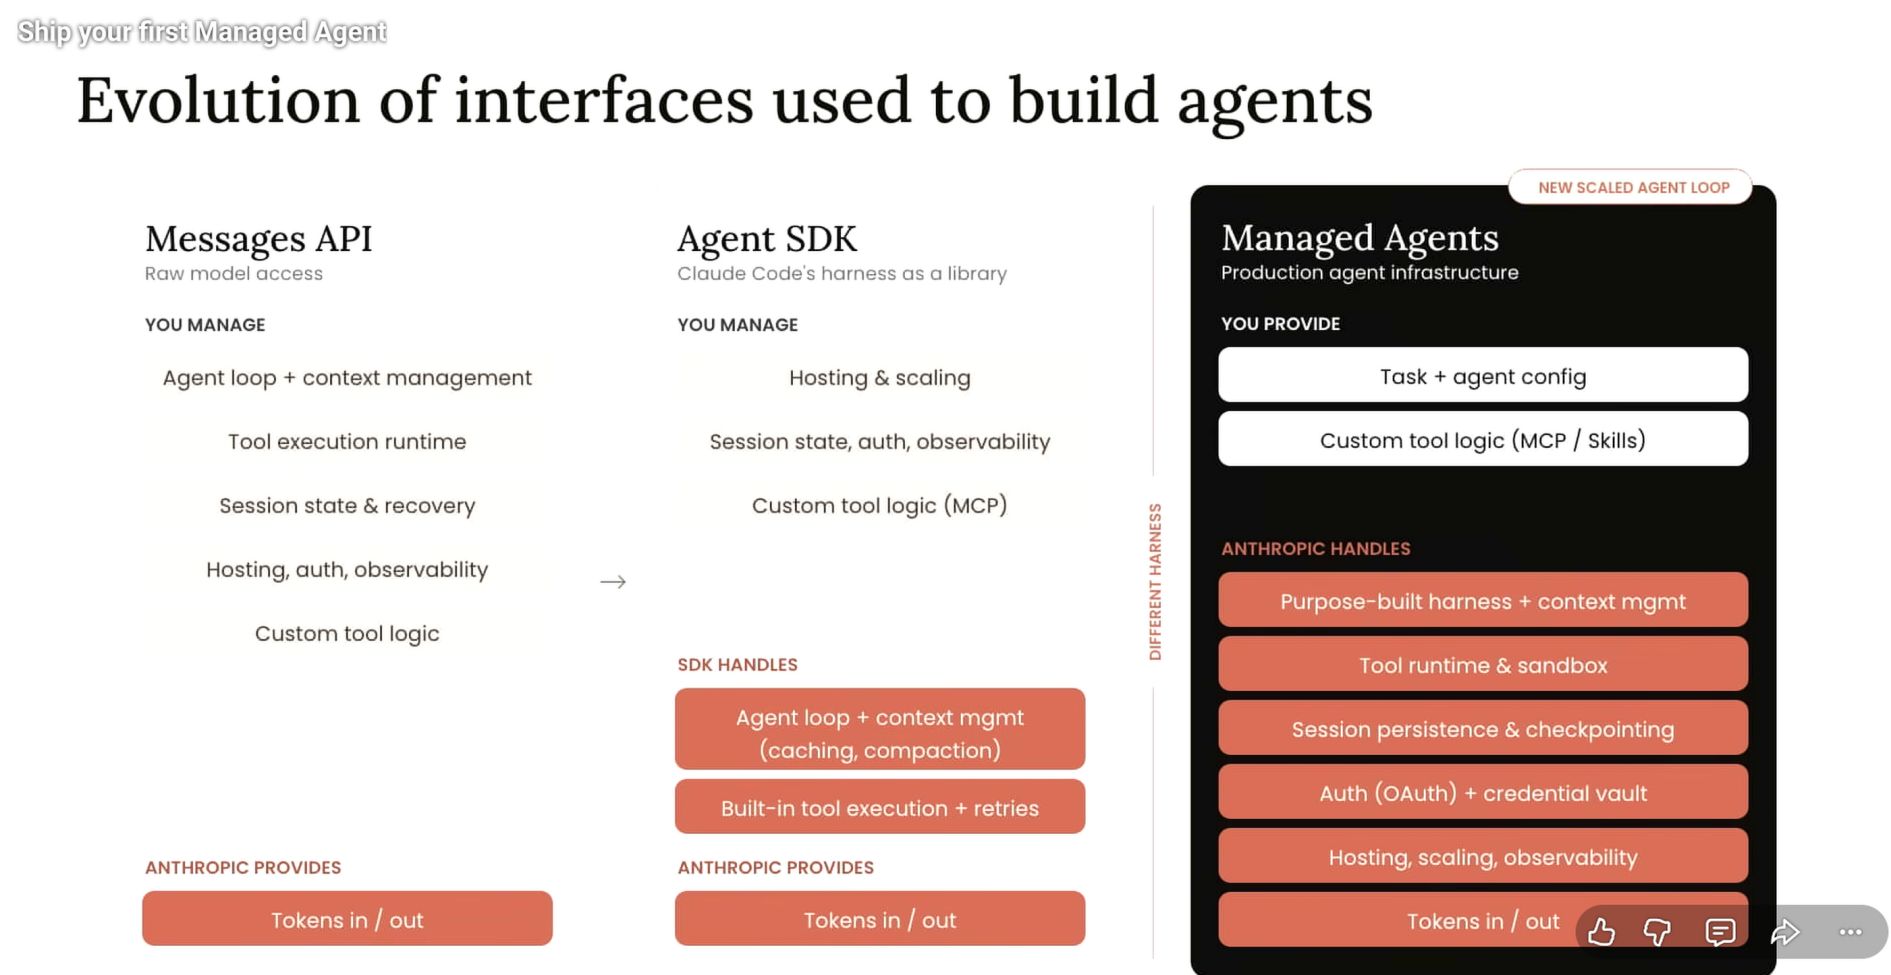
Podział z tego slajdu jest użyteczny nie jako marketing, tylko jako mapa odpowiedzialności — pokazuje, co przestaje być Twoim problemem, a więc też, nad czym tracisz kontrolę.
| Warstwa | Ty zarządzasz | Anthropic dostarcza |
|---|---|---|
| Messages API (2023) | pętla agenta, zarządzanie kontekstem, runtime narzędzi, stan sesji, hosting, auth, obserwowalność | tokeny in/out |
| Agent SDK | hosting i skalowanie, stan sesji, auth, obserwowalność, logika narzędzi (MCP) | pętla agenta z cache'owaniem i kompakcją, wykonanie narzędzi z retry |
| Managed Agents | task i konfiguracja agenta, własna logika narzędzi (MCP / Skills) | harness, runtime narzędzi i sandbox, persystencja sesji i checkpointing, OAuth + vault na poświadczenia, hosting, skalowanie, obserwowalność |
Argument Anthropic za oddaniem harnessu jest konkretny i wart zapamiętania, bo nie jest argumentem o wygodzie. He opisuje przypadek Sonnet 4.5 i zachowania nazwanego przez zespół context anxiety: model kończył zadanie przedwcześnie, mimo że miał jeszcze zapas w oknie kontekstowym. Zespół dołożył w harnessie mitygacje przeciw temu wczesnemu zatrzymywaniu. Po wyjściu Opus 4.5 zachowanie zniknęło, a cała ta praca stała się zbędna.
To jest realny koszt utrzymania własnego harnessu: obejścia pisze się pod konkretną wersję modelu i trzeba je wycofywać przy następnej. Deklaracja „10–15 razy szybciej do produkcji" z tej samej prezentacji to już liczba marketingowa dostawcy — traktuję ją jako taką i nie powtarzam jej jako ustalenia.
Trzy prymitywy i jedna decyzja architektoniczna
Budowa agenta sprowadza się do trzech obiektów, w warsztacie tworzonych siedmioma funkcjami:
# 1. Agent — "mózg": model, system prompt, narzędzia, serwery MCP, skille
agent = client.beta.agents.create(
    name="SRE Agent", model="claude-opus-4-7", system=SYSTEM, tools=TOOLS,
)

# 2. Environment — "ręce": kontener, w którym agent działa
env = client.beta.environments.create(
    name=f"sre-agent-{uuid.uuid4().hex[:6]}",
    config={"type": "cloud", "networking": {"type": "unrestricted"}},
)

# 3. Session — spina jedno z drugim i strumieniuje zdarzenia
session = client.beta.sessions.create(agent=agent.id, environment=env.id, ...)
Najważniejsza jest tu decyzja, której w kodzie nie widać: pętla agenta jest odklejona od wykonania narzędzi. W większości harnessów — także w Claude Code — jedno chodzi w tym samym kontenerze, co jest sensowne, gdy agent ma świadomie mieć dostęp do całego systemu plików. Managed Agents rozdziela te dwie rzeczy i He podaje dwa powody.
Pierwszy jest bezpieczeństwowy: rozdzielenie pozwala trzymać poświadczenia poza zasięgiem mózgu agenta. Drugi jest wydajnościowy i został podany z liczbą — przy sprzężonej pętli trzeba było wystawiać kontener dla każdej sesji, a po rozdzieleniu zespół zmierzył ponad 90% redukcji time-to-first-token dla P95.
Z perspektywy governance to rozdzielenie jest ważniejsze niż z perspektywy latencji, bo z niego wynikają wszystkie kontrole opisane niżej. Nie da się zbudować sensownego vaultu, jeśli komponent planujący działania i komponent wykonujący je są tym samym procesem.
Sesja mówi zdarzeniami, nie odpowiedziami
Managed Agents nie działa w modelu request/response. Sesja dopisuje zdarzenia do logu: wiadomość użytkownika, wywołanie narzędzia przez agenta, odpowiedź agenta. Z tego wynikają trzy rzeczy naraz — wznawialność, strumieniowanie do UI i, co najciekawsze z mojej perspektywy, gotowy ślad audytowy. Każde wywołanie narzędzia jest wpisem w logu sesji, a konsola deweloperska ma wbudowany podgląd.
To jest dokładnie ten artefakt, którego katalog Customize nie daje. Zadanie cykliczne odpalone z panelu ustawień nie zostawia niczego, co dałoby się pokazać audytorowi; sesja Managed Agents zostawia log zdarzeń.
Sesja jest maszyną stanów o czterech statusach:
| Status | Znaczenie | Przejście |
|---|---|---|
idle | stan startowy, czeka na wejście — wiadomość użytkownika albo potwierdzenie narzędzia | budzi ją każde zdarzenie user.* |
running | agent wykonuje pętlę | wraca do idle przez session.status_idle (end_turn lub requires_action) |
rescheduling | błąd przejściowy, system ponawia automatycznie | auto-retry z powrotem do running |
terminated | błąd nieodwracalny | koniec |
Na rescheduling warto się zatrzymać, bo to moja własna uwaga, nie teza z prezentacji: automatyczny retry na narzędziu, które nie jest idempotentne, to gotowy problem. Jeśli agent ma narzędzie zakładające ticket, wysyłające wiadomość albo zapisujące do bazy, a sesja wpadnie w rescheduling po częściowo wykonanym wywołaniu, dostaniesz duplikat. Idempotencja narzędzi zapisujących to w tym modelu wymóg, nie dobra praktyka.
Persystencja jest po stronie chmury — w demo widać to dosłownie: sesja opisana jest jako „persisted in the cloud, not this browser", a twarde odświeżenie strony nie gubi historii. Druga strona tego medalu: rozmowa, wyniki narzędzi i wgrane pliki żyją na infrastrukturze dostawcy. Kontrolą jest jawne kasowanie sesji, które — według prezentacji — usuwa dane także z logów. Retencja staje się więc decyzją projektową, którą trzeba podjąć, a nie ustawieniem, które można przeoczyć.
Kontrole, których w katalogu nie było
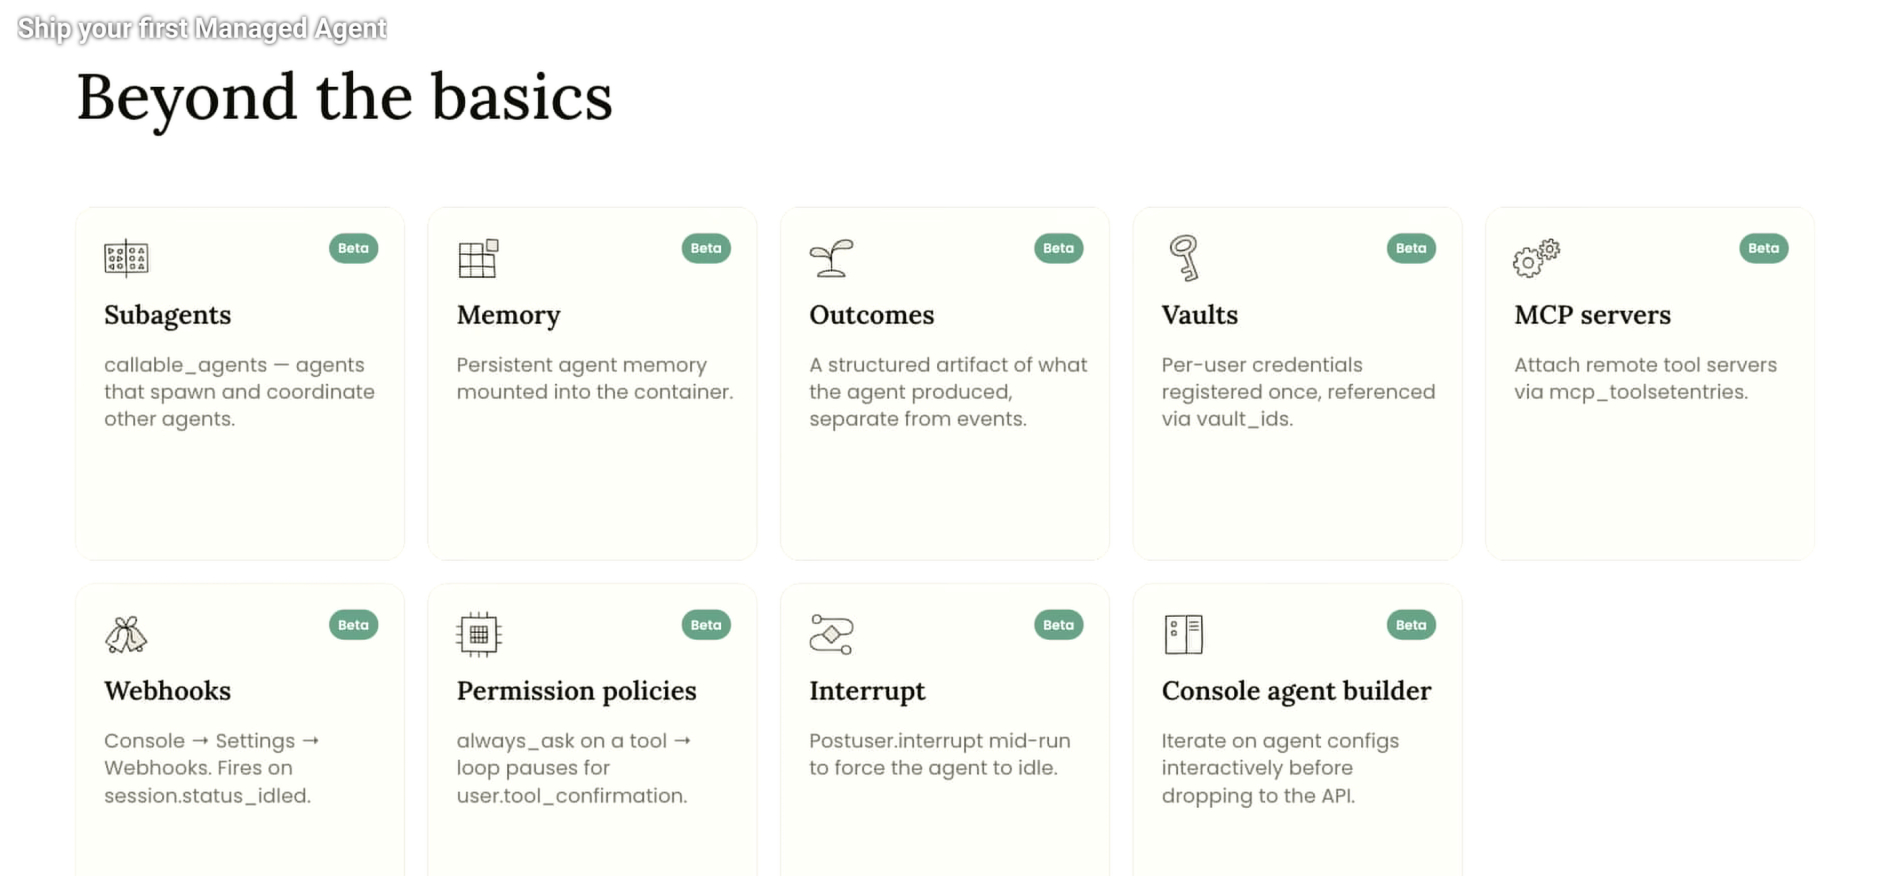
Tu robi się ciekawie, bo trzy z tych kafelków odpowiadają wprost rekomendacjom, które w poprzednim wpisie musiałem sformułować jako postulaty procesowe.
Allowlista sieciowa na środowisku. Pole networking w konfiguracji środowiska to lista dozwolonych adresów. W warsztacie ustawione jest {"type": "unrestricted"} i He mówi wprost, że można to zawęzić do konkretnych witryn. To jest egzekwowalna wersja postulatu „zadanie czytające treści z internetu nie ma w tej samej sesji dostępu do danych wewnętrznych" — tyle że tutaj wymusza ją kontener, a nie regulamin. Dochodzą do tego MCP tunnels, pozwalające trzymać serwery MCP w sieci prywatnej zamiast na publicznej.
Permission policies. Ustawienie always_ask na narzędziu zatrzymuje pętlę i czeka na zdarzenie user.tool_confirmation. To jest bramka akceptacyjna jako prymityw protokołu. Do tego Interrupt: wysłanie user.interrupt w trakcie działania zrzuca sesję do idle. Człowiek w pętli przestaje być kwestią dyscypliny operacyjnej.
Vaults. Poświadczenia rejestruje się raz i referencuje przez vault_ids, per użytkownik i per sesja, z szyfrowaniem między magazynem a agentem. Działa to właśnie dzięki rozdzieleniu mózgu od rąk. To odpowiedź na najbardziej niewygodny punkt poprzedniego wpisu — że domyślny przepływ OAuth daje agentowi tyle uprawnień, ile ma osoba klikająca „Connect".
Pozostałe kafelki są mniej związane z bezpieczeństwem, ale warto je znać: Subagents (callable_agents — orkiestracja z osobnymi oknami kontekstu), Memory (pamięć montowana do kontenera), Outcomes (rubryka definiująca oczekiwany rezultat zamiast listy kroków), Webhooks (Console → Settings → Webhooks, wyzwalane na session.status_idled), MCP servers (wpisy mcp_toolset) oraz Console agent builder.
Słaby punkt — i jest poważny: na slajdzie każdy z tych dziewięciu kafelków ma plakietkę Beta. Wszystkie kontrole, dla których warto byłoby przenieść agenta produkcyjnego z katalogu na tę platformę, są funkcjami w wersji beta. To nie dyskwalifikuje Managed Agents, ale zmienia rozmowę: nie planujesz migracji na dojrzałą platformę bezpieczeństwa, tylko podejmujesz zakład na to, że ta beta dojedzie do GA w Twoim horyzoncie wdrożeniowym. Pytanie do dostawcy przed decyzją brzmi: które z tych dziewięciu funkcji mają datę GA i jakie są gwarancje zgodności API.
Demo: gdzie ta architektura faktycznie działa
Warsztatowy agent to SRE debugujący incydent. Dane wejściowe: INCIDENT-2277, checkout z opóźnieniem p99 na poziomie 3638 ms (10× powyżej baseline, +5726%), error rate 21,9%, pula połączeń do bazy wysycona w 100%, incydent trwa 28 minut. Agent dostaje trzy narzędzia lokalne (get_metrics, get_recent_deploys, get_diff), log wgrany przez Files API i sandbox z bashem.
Wynik: agent zidentyfikował wyczerpanie puli połączeń jako przyczynę, wskazał commit refaktoryzujący builder podsumowania zamówienia jako źródło problematycznego zapytania, wykluczył inne hipotezy i zaproponował działania naprawcze.
Dwie rzeczy z tego demo są istotniejsze niż sam wynik. Po pierwsze, narzędzia w warsztacie czytają z lokalnych plików JSON, ale — jak zauważa He — ten sam protokół obsługuje klienta Datadoga; przejście z prototypu na produkcję nie wymaga przepisania agenta, tylko podmiany implementacji narzędzia. Po drugie, system prompt tego agenta jest bardzo prosty. Ciężar nie leży w prompcie, tylko w tym, jakie narzędzia i jakie dane agent dostaje — i to jest zgodne z tym, co widać w praktyce przy budowaniu takich rzeczy.
Naturalne rozwinięcie, które He sygnalizuje, ale którego w demo nie pokazuje: dołożenie agentowi dostępu do repozytorium i możliwości wystawienia PR-a, żeby domykał incydent, a nie tylko go opisywał. To jest moment, w którym wszystkie kontrole z poprzedniej sekcji przestają być opcjonalne.
Co z tego wynika praktycznie
- Jeśli budujesz agenta produkcyjnego, katalog Customize to zła warstwa. Nie dlatego, że jest niebezpieczny sam w sobie, tylko dlatego, że nie ma w nim miejsca, w którym da się zapisać ograniczenie. Managed Agents ma takie miejsca — allowlista, polityka uprawnień, vault.
- Rozdzielenie mózgu od rąk jest warunkiem wstępnym, nie optymalizacją. Jeżeli oceniasz inną platformę agentową, to jest pierwsze pytanie do zadania: czy komponent planujący ma dostęp do poświadczeń, którymi posługuje się komponent wykonujący.
- Sprawdź idempotencję każdego narzędzia zapisującego, zanim wystawisz agenta na
reschedulingz auto-retry. - Domyślne
unrestrictedw materiałach szkoleniowych to nie jest ustawienie produkcyjne. Warsztat uczy najbardziej permisywnej konfiguracji sieciowej, bo tak jest wygodniej na demo. Łatwo to przenieść do repozytorium i zapomnieć. - Zapytaj o daty GA, zanim oprzesz model zagrożeń na funkcji oznaczonej Beta.
Wątek warto ciągnąć w stronę samego protokołu — słabe punkty MCP, na którym to wszystko stoi, opisywałem w 10 krytycznych lukach Model Context Protocol.